Warum ich Python für die Datenanalyse bevorzuge

Ich habe kürzlich viel über Datenanalyse mit Python geschrieben. Ich wollte erklären, warum es eine bevorzugte Sprache ist. Hier sind einige Gründe, warum ich Python so einfach zu benutzen und gleichzeitig so leistungsfähig finde.
Python bietet schnelle interaktive Berechnungen
Python ermöglicht es mir, statistische Berechnungen viel schneller durchzuführen, als ich es jemals von Hand könnte. Als ich mit meinem Statistik-Kurs am College begann, musste ich grundlegende deskriptive Statistiken wie Mittelwert, Median und Standardabweichung berechnen. Die Länge der Datensätze machte dies umständlich, selbst mit dem wissenschaftlichen Taschenrechner, den ich hatte. Habe ich die Daten korrekt eingegeben? Schnell wechselte ich zu dem TI-Grafikrechner, den ich besaß. Das Lehrbuch, das ich benutzte, zeigte zufällig die statistischen Funktionen für dieses Modell.
Ich glaube, ich habe meinen grafischen Taschenrechner noch irgendwo. Ich benötige ihn nicht mit Python. Der Standardwitz ist, dass man ihn als Desktop-Taschenrechner verwenden kann. Der Interpreter allein ist einfach für grundlegende Berechnungen zu nutzen. Ein Upgrade auf IPython bietet viele Annehmlichkeiten, die interaktives Python erheblich erleichtern können, wie zum Beispiel die Rückruffunktion für die Eingabeverlaufshistorie.
Obwohl ich es gelegentlich mag, mit meinem Casio-Wissenschaftsrechner herumzuspielen, weil ich die haptischen Tasten mag, ist die Arbeit mit Python viel einfacher. Ich kann in Python sofort eine Liste von Zufallszahlen erzeugen und beschreibende Statistiken finden. Ich kann Operationen auf Listen mit 100 Elementen ausführen. Das wäre von Hand oder sogar mit einem Taschenrechner schwierig. Python ist einfach viel einfacher.
Viele Bibliotheken, die Dinge einfacher machen
Eines der besten Merkmale von Python ist die Anzahl der Bibliotheken, die man mit der Sprache verwenden kann. Python bringt nicht nur viele Bibliotheken von Haus aus mit, ein Ansatz, den es "Batterien inklusive" nennt, sondern es gibt auch viele weitere Bibliotheken, die ich für die Datenanalyse nutzen kann.
Die integrierten Mathematik- und Statistikbibliotheken sind hilfreich für grundlegende Berechnungen, aber es gibt noch bessere, die ich regelmäßig in meiner Mamba-Umgebung einrichte.
Eine Grundlage ist NumPy. Dies ist eine Bibliothek zur effizienten Erstellung und Verarbeitung großer numerischer Arrays, aber sie bringt auch viele Funktionen mit, die ich auf ihnen ausführen kann, wie lineare Algebra und Statistik. Letzteres wird der Schwerpunkt dieses Artikels sein.
Lass mich eine Liste zufälliger Zahlen erstellen.
Zuerst werde ich den Zufallszahlengenerator von NumPy einrichten:
import numpy as np
rng = np.random.default_rng()
Jetzt werde ich eine Liste von 20 zufälligen Zahlen erstellen:
a = rng.random(20)
Ich kann den Mittelwert dieser Liste berechnen:
np.mean(a)
Ich kann auch die Standardabweichung nehmen:
np.std(a)
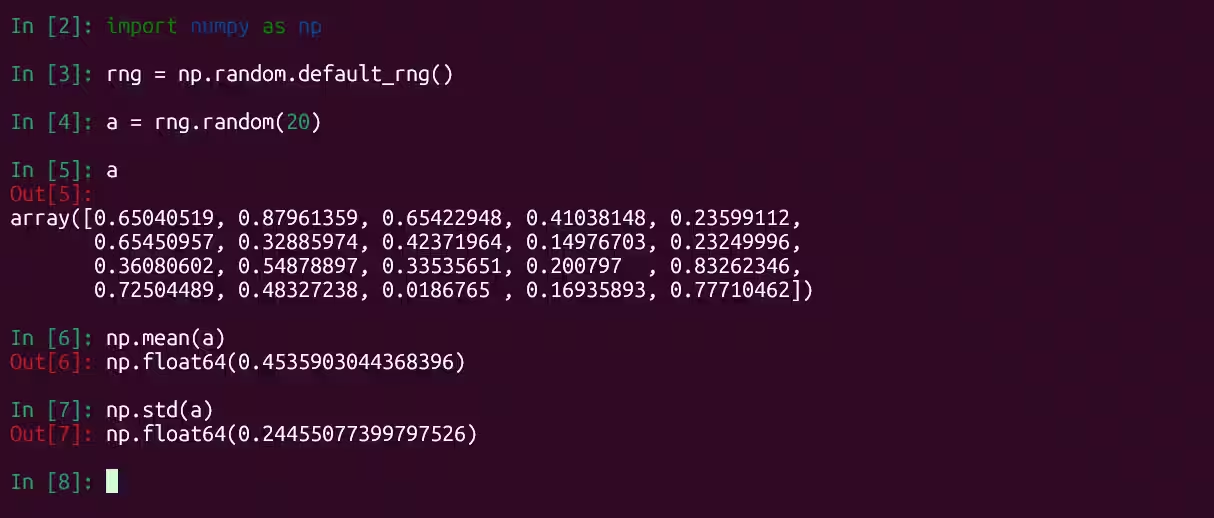
Dies sind einige grundlegende Operationen. Es sind die anderen Bibliotheken, die mich bei Python halten.
Grafiken sind eine leistungsstarke Möglichkeit, Ihre Daten zu erkunden. Seaborn, über das ich bereits geschrieben habe, ist ein leistungsstarkes Werkzeug. Ein gutes Beispiel ist die Visualisierung von Streudiagrammen und linearen Regressionen.
Lassen Sie uns ein Beispiel aus Seaborn verwenden. Wir werden einen Datensatz von Restaurantrechnungen in New York City importieren, zusammen mit Trinkgeldern und anderen Variablen, wie der Anzahl der Personen am Tisch und ob sie Raucher waren oder nicht.
Lassen Sie uns den Trinkgeldbetrag im Vergleich zur Gesamtrechnung darstellen:
tips = sns.load_dataset('tips')
sns.regplot(x='total_bill',y='tip',data=tips)

Ich kann auch Boxplots und Balkendiagramme mit Seaborn anzeigen. Lassen Sie uns die Gesamtrechnungen in den Restaurants über mehrere Tage ansehen:
sns.catplot(x='day',y='total_bill',kind='bar',data=tips)

Ich kann Daten auch formeller mit Pingouin untersuchen, einer Bibliothek zur Durchführung statistischer Tests. Schauen wir uns erneut die Trinkgeld-Datenbank an. Auf die Zahl, die man beachten sollte, ist der Korrelationskoeffizient, der angibt, wie gut die Linie zu den Daten passt. Das Quadrat des Korrelationskoeffizienten ist in der Spalte "r2" aufgeführt.
pg.linear_regression(tips['total_bill'],tips['tip'])

Manchmal möchte man beobachten, wie sich ein Wert über verschiedene Kategorien hinweg verändert. Dafür ist die Varianzanalyse, oder ANOVA, nützlich.
Kommen wir von Restaurantrechnungen zu Pinguinschnäbeln. Dieser Code untersucht einen Datensatz mit drei Pinguinarten: Adélie, Zügelpinguin und Eselspinguin. Wir werden sehen, ob der Unterschied in der Schnabellänge in Millimetern zwischen den Arten signifikant ist.
penguins = pg.read_dataset('penguins')
pg.anova(data=penguins,dv='bill_length_mm',between='species').round(2)

Der p-Wert beträgt 0,0, was bedeutet, dass die Unterschiede signifikant sind
Intuitivere Methodennamen
R war traditionell der Spitzenreiter in der Datenanalyse, was Programmiersprachen angeht, aber die Tatsache, dass die Methodenamen von Python einprägsamer zu sein scheinen, macht Python für mich zur ersten Wahl.
Ich habe kein Problem mit R selbst. Ich habe es schon zuvor benutzt, und es ist eine großartige Sprache für Datenanalyse, aber vielleicht einfach nicht so gut für mich. Zum Beispiel wird anstelle des Gleichheitszeichens eine Zuweisung an einen Vektor, die Liste von Zahlen ähnlich wie bei NumPy-Arrays, verwendet. Die Tab-Vervollständigung in IPython macht das Eingeben von Befehlen viel einfacher, als alles erneut zu tippen, und ich kann den Verlaufsmechanismus verwenden, um zuvor eingegebene Befehle wieder aufzurufen.
Viele Daten zum Spielen
Ich hatte mich schon lange für Datenanalyse interessiert, besonders seit ich hörte, dass Python und seine Bibliotheken zunehmend verwendet wurden. Ich hatte schon etwas Erfahrung mit Python, aber ich wollte mich einbringen. Aber wo sollte ich Daten finden?
Glücklicherweise ist es einfach, Daten zu finden. Wie bereits erwähnt, ermöglichen viele Bibliotheken den Zugriff auf öffentliche Datensätze, sodass Sie lernen können, wie diese Bibliotheken funktionieren, und ihre Ergebnisse überprüfen können. Wir haben dies in den vorherigen Beispielen gesehen.
Eine andere Möglichkeit, Daten zu erhalten, besteht darin, sie zufällig zu erzeugen. Dies ist eine weitere Methode, die nützlich ist, um zu lernen, wie eine Bibliothek funktioniert. Der einzige Nachteil von Zufallsdaten ist, dass sie sich jedes Mal ändern.
Ich kann auch meine eigenen Datensätze erstellen. Das habe ich für ein kürzliches Projekt getan, bei dem es um die Akkulaufzeit von Telefonen und Tablets ging.
Es gibt auch viele Datensätze, die andere Leute auf Seiten wie Kaggle erstellt haben, die ich herunterladen und mit den oben erwähnten Werkzeugen erkunden kann. Ich kann sogar Daten von Regierungswebsites herunterladen.
Interaktive Operationen geben sofortiges Feedback
Eine Sache, die ich an Python in der Datenanalyse mag, ist, dass der interaktive Modus mir sofortiges Feedback gibt. Ich muss nicht auf einen Kompilierzyklus warten oder ein Skript schreiben, bevor ich meine Ergebnisse sehen kann. Wenn ich eine Berechnung in IPython ausführe, sehe ich das Ergebnis im Terminalfenster. Wenn ich ein Diagramm erstelle, erscheint es in einem anderen Fenster.
Oft, wenn ich Daten durchgehe, bekomme ich Ideen für andere Operationen, die ich durchführen möchte. Ich kann dann darauf reagieren. Das ist die wahre Stärke des interaktiven Programmierens.
Jupyter-Notebooks ermöglichen es mir, meine Berechnungen aufzuzeichnen

So nützlich IPython auch ist, viele der Operationen, die ich durchführe, werden nach dieser Sitzung verschwunden sein, nachdem ich das Fenster geschlossen habe. Ich kann alle Diagramme speichern, aber die Berechnungen werden wahrscheinlich verloren sein. Ich kann ein Protokoll einrichten, aber ich muss daran denken, das zu tun. Wenn ich mich daran erinnern möchte, wie ich etwas gemacht habe, muss ich die Befehlshistorie durchsuchen.
Dies könnte der Grund sein, warum die Entwickler von IPython die Jupyter-Notebook-Oberfläche erstellt haben. Jupyter ermöglicht es mir, interaktive Notebooks zu erstellen. Ich erstelle normalerweise eines, wenn ich einen Datensatz untersuche und die Ergebnisse festhalten möchte. Ich kann später darauf zurückkommen, wann immer ich will. Das andere Gute ist, dass ich Jupyter-Notebooks mit anderen Personen teilen kann, zum Beispiel auf meinem GitHub-Konto.
Jupyter ist aus gutem Grund zu einem de facto Standard in der wissenschaftlichen Datenverarbeitung geworden. Es ist einfach genug, damit Wissenschaftler aller Art ihre Erkenntnisse aufzeichnen und mit ihren Kollegen teilen können.
Dies sind die Gründe, warum Python meine bevorzugte Programmiersprache ist, besonders für die Datenanalyse. Es ist eine einfache Sprache, um damit zu beginnen, und sie ist mit mir gewachsen, während ich mehr gelernt und meine Fähigkeiten erweitert habe.