Wie man das Python-Statistikmodul verwendet
Sprunglinks
- Was ist das Python-Statistikmodul?
- Beschreibende Statistik
- Regression und Korrelation
- Die Normalverteilung
- Wie steht es mit NumPy, SciPy usw.?
Python verfügt über einige wunderbare Bibliotheken für die statistische Analyse, aber sie könnten für einfache Aufgaben übertrieben sein. Die eingebaute Statistikbibliothek könnte stattdessen das Richtige für Sie sein. Hier sind einige Dinge, die Sie damit tun können. Sie müssen sich keine komplizierten Formeln merken oder Tabellen durchsuchen.
Was ist das Python-Statistikmodul?
Das Python-Statistikmodul ist ein eingebautes Modul zur Durchführung einfacher statistischer Berechnungen. Da es Teil der Standardbibliothek von Python ist, ist es in jeder Python-Installation verfügbar. Um darauf in Skripten oder interaktiven Sitzungen zuzugreifen, müssen Sie es lediglich importieren:
import statistics
Wenn Sie nur eine oder wenige Funktionen aus einem Python-Modul in einer interaktiven Sitzung benötigen, zum Beispiel in IPython oder einem Jupyter-Notebook, können Sie diese direkt in den aktuellen Namensraum importieren, sodass Sie nicht ständig "statistics" eintippen müssen. Auf diese Annahme beruhen die Beispiele in diesem Artikel.
Das Statistikmodul glänzt in einem interaktiven Python-Modus wie dem Interpreter, einer erweiterten Sitzung in IPython oder einem Jupyter-Notebook.
Beschreibende Statistik
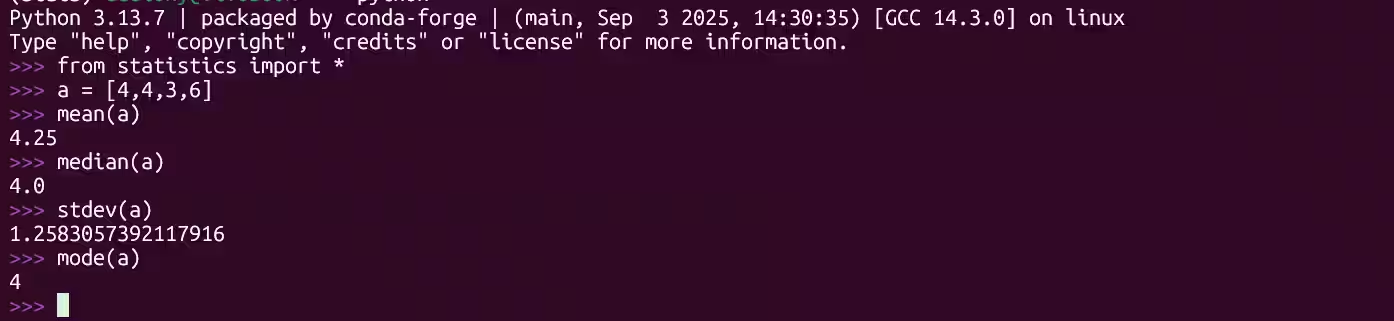
Die grundlegendste Form der Statistik ist die deskriptive Statistik. Wie der Name schon sagt, dienen diese Statistiken dazu, die Daten zu beschreiben, wie zum Beispiel deren zentrale Tendenzen oder Streuungsmaße.
Die einfachste Berechnung ist der arithmetische Mittelwert, der einfach die Summe der Datenpunkte geteilt durch die Anzahl der Datenpunkte ist. In Statistik-Lehrbüchern wird der Stichprobenmittelwert durch ein x mit einem darübergezogenen Strich dargestellt, bekannt als „x Strich“. Der Populationsmittelwert wird durch den griechischen Buchstaben Mu dargestellt, aber die Berechnung ist dieselbe. Die meisten Menschen werden dies als den „Durchschnitt“ kennen.
Um den Mittelwert mit dem Statistikmodul zu berechnen, verwenden Sie einfach die Funktion mean.
Importiere Funktionen nur in das Haupt-Python-Namensraum in interaktiven Sitzungen. Dies kann in Skripten Fehler verursachen, wenn die importierte Funktion eine eingebaute Funktion überschreibt.
Lass uns ein kleines Zahlenarray erstellen und den Mittelwert berechnen:
a = [4,4, 3, 6]
mean(a)
Das Ergebnis ist 4,6.
Die Funktion fmean berechnet ebenfalls Mittelwerte, wandelt die Daten jedoch in Fließkommazahlen um. Sie ermöglicht auch die Berechnung eines gewichteten Mittels.
weights = [1,2,3,4]
fmean(a,weights)
Der gewichtete Mittelwert aus diesem Beispiel beträgt 4,5
Eine andere Art von Mittelwert ist der geometrische Mittelwert, der nützlich ist, um Wachstumsraten über einen bestimmten Zeitraum zu vergleichen. Dabei wird die n-te Wurzel aus den multiplizierten Datenpunkten genommen. Von Hand bedeutet das normalerweise mühsame Logarithmusberechnungen, aber in Python ist es mit der Funktion geometric_mean einfach.
geometric_mean(a)
Das harmonische Mittel ist der Kehrwert des arithmetischen Mittels. Es ist die Anzahl der Datenpunkte geteilt durch die Summe der Brüche 1/des ersten Datenpunkts, 1/des zweiten Datenpunkts und so weiter. Das harmonische Mittel ist nützlich, um Durchschnittswerte von Dingen wie Geschwindigkeiten zu berechnen, die bestimmte Raten haben. Zum Glück kann Python dies ebenfalls für Sie erledigen.
harmonic_mean(a)
Das Ergebnis ist 4. Beachten Sie, dass das harmonische Mittel kleiner war als das geometrische Mittel und das geometrische Mittel kleiner war als das arithmetische Mittel bei derselben Datenreihe.
Der Median ist ein weiteres beliebtes Maß der zentralen Tendenz. Er ist der Datenpunkt, der einen Datensatz in zwei Hälften teilt. Sie können ihn mit der Median-Funktion finden:
median(a)
Das Ergebnis ist in unserem Beispiel 4.
Die Modusfunktion gibt die am häufigsten vorkommende Zahl in der Stichprobe an.
mode(a)
Nochmals, der Modus ist 4, da es die am häufigsten vorkommende Zahl in dem zuvor definierten Array ist.
Ein weiterer häufiger Grund für die Durchführung von deskriptiven Statistiken ist die Messung der Streuung der Daten, auch bekannt als Dispersion. Das bekannteste Maß für Streuung ist die Standardabweichung, die misst, wie weit die Daten vom arithmetischen Mittelwert entfernt sind. Sie ist die Quadratwurzel der Varianz, also die Summe der Quadrate der vom Mittelwert abgezogenen einzelnen Datenpunkte, geteilt durch die Anzahl der Datenpunkte. Dies stellt die Standardabweichung der Population dar, während die Standardabweichung bei kleineren Stichproben die Anzahl der Datenpunkte um eins verringert, um ein repräsentativeres Ergebnis zu erhalten.
Die Funktion stdev berechnet die Stichprobenstandardabweichung, was wahrscheinlich das ist, was Sie die meiste Zeit wollen:
stdev(a)
Das Ergebnis beträgt ungefähr 1,26.
Vergleichen wir es mit der Standardabweichung der Population mit der pstdev-Funktion:
pstdev(a)
Sie können die Stichprobenvarianz mit der Varianzfunktion anzeigen
variance(a)
Es gibt auch eine populationsbasierte Variante, pvariance, die auf die gleiche Weise funktioniert.
Eine weitere Möglichkeit, die Verteilung Ihrer Daten zu betrachten, besteht darin, sie in Perzentile zu unterteilen, die den Prozentsatz der Datenpunkte angeben, die darunter liegen. Der Median ist tatsächlich das 50. Perzentil, da die Hälfte der Datenpunkte darunter liegt.
Die Quantile-Funktion teilt die Daten nach Ergebnis in Perzentile auf:
quantiles(a)
Es wird das untere Quartil bzw. das 25. Perzentil, den Median und das obere Quartil anzeigen. Die eingebauten Min- und Max-Funktionen zeigen die Minimal- und Maximalwerte an.
min(a)
max(a)
Regression und Korrelation
Eine beliebte statistische Methode besteht darin, zu sehen, wie eine Variable mit einer anderen korreliert. Dies bedeutet, dass man Datenpunkte auf x- und y-Achsen darstellt und eine Linie darüber zeichnet, um zu sehen, wie gut sie passt. Dies ist als "lineare Regression" bekannt. Das Statistikmodul hat eine Methode für einfache lineare Regression. Sie ist "einfach", weil sie nur zwei Variablen korreliert. Sie verwendet eine Methode namens "kleinste Quadrate", so genannt, weil sie versucht, das Quadrat des Abstands zwischen den Datenpunkten und der von ihr erstellten Linie zu minimieren.
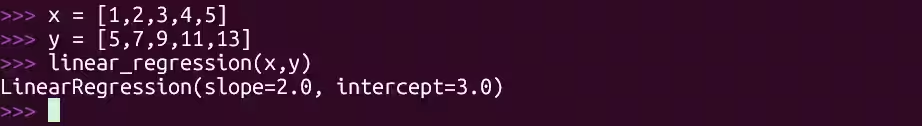
Lassen Sie uns eine lineare Regression von zwei Arrays mit den Bezeichnungen x und y darstellen
x = [1,2,3,4,5]
y = [5,7,9,11,13]
Um das Modell anzupassen, verwenden Sie die Methode linear_regression. Dies berechnet die Steigung und den y-Achsenabschnitt für die bekannte Gleichung einer Geraden: y=mx + b.
linear_regression(x,y)
Dies gibt Ihnen die Steigung und den Achsenabschnitt. Sie können sie auch in Variablen speichern:
slope, intercept = linear_regression(x,y)
Die Steigung in diesem Fall beträgt 2 und der Achsenabschnitt 3, was die Steigungs-Abschnitt-Gleichung y=2*x + 3 darstellt. Das positive Vorzeichen der Steigung zeigt an, dass es sich um eine nach oben geneigte Linie handelt, was bedeutet, dass der y-Wert steigt, wenn wir uns nach rechts bewegen.
Diese Funktion wird keine Linien oder das klassische Streudiagramm anzeigen. Sie liefert außerdem nur die Regression für zwei Variablen. Wenn Sie ein Diagramm erstellen oder eine Vorhersage mit mehr als einer abhängigen Variablen machen möchten, müssen Sie andere Bibliotheken wie Seaborn, statsmodels oder Pingouin verwenden.
Sie können sehen, wie gut zwei Variablen korrelieren, indem Sie die Korrelationsfunktion verwenden. Diese berechnet den Korrelationskoeffizienten, oder r. Dieser Koeffizient liegt zwischen 0 und 1 oder -1 und zeigt eine positive oder negative Korrelation an. Eine negative Korrelation bedeutet eine abwärts geneigte Linie.
Um die Korrelation zwischen zwei Variablen zu überprüfen:
correlation(x,y)
In diesem Fall beträgt der Wert 1, was eine perfekte positive Korrelation zeigt, aber reale Daten korrelieren selten so perfekt. Das bedeutet, dass die Regressionslinie genau auf den Datenpunkten liegen wird, wenn Sie sie aufzeichnen.
Die Normalverteilung

Die Normalverteilung mit ihrer berühmten glockenförmigen Kurve ist eine kontinuierliche Wahrscheinlichkeitsverteilung. Sie können die Funktion verwenden, um die Wahrscheinlichkeit eines normalverteilten Parameters zu schätzen.
Dies können wir mit Daten der CDC demonstrieren. Laut den Daten beträgt der Mittelwert der Männer über 20 Jahre 175,1 Zentimeter. Die Standardabweichung der Bevölkerung können wir erhalten, indem wir die Quadratwurzel der Stichprobengröße, 2.690, mit dem Standardfehler, 0,3, multiplizieren.
import math
math.sqrt(2690) * .3
Die Standardabweichung beträgt ungefähr 15,56
Wir können dies verwenden, um ein Objekt der Normalverteilung zu erstellen:
men_height = NormalDist(175.1,28.41)
Um den Prozentsatz der Männer zu finden, die zwischen 160 und 180 Zentimetern groß sind, verwenden wir die kumulative Verteilungsfunktion, oder CDF, die den Prozentsatz der Werte unterhalb eines bestimmten Werts angibt. Wir können den kleineren Wert vom größeren subtrahieren, da die Normalverteilungskurve symmetrisch ist. Das Objekt, das wir gerade erstellt haben, verfügt über eine CDF-Methode, die wir verwenden können, um uns diese Wahrscheinlichkeit zu geben.
men_height.cdf(180) - men_height.cdf(160)
Die Antwort wird sein, dass ungefähr 45 % der Männer zwischen 160 und 180 Zentimetern groß sind.
Wie steht es mit NumPy, SciPy usw.?
NumPy, SciPy und andere Bibliotheken sind beliebt für Statistik und Datenanalyse. Wo lässt das das Statistikmodul stehen? Die erstgenannten Bibliotheken sind für große Datensätze und den professionellen Einsatz konzipiert. Die Entwickler des Statistikmoduls haben es auf dem Niveau von wissenschaftlichen Rechnern und Grafikrechnern angesiedelt. Diese Bibliothek ist gut geeignet, um statistische Konzepte zu lernen und schnelle, beiläufige Berechnungen durchzuführen.
Wenn Sie mit echten Datensätzen arbeiten möchten, sind die anderen Bibliotheken leistungsfähiger und flexibler, obwohl die Lernkurve steil sein kann. Wenn Sie einen Vorgeschmack auf die Leistungsfähigkeit der statistischen Berechnung mit Python erhalten möchten, ist das Statistikmodul ein guter Ausgangspunkt.