Wie man pandas DataFrames in Python verwendet, um Daten zu analysieren und zu bearbeiten
Sprunglinks
- Was ist Pandas?
- Was ist ein DataFrame?
- Wie man ein DataFrame erstellt
- Importieren eines DataFrames
- Untersuchung eines DataFrame
- Spalten hinzufügen und löschen
- Operationen an Spalten ausführen
Wenn Sie Daten in Python analysieren möchten, sollten Sie sich mit pandas vertraut machen, da es die Datenanalyse erheblich erleichtert. Das DataFrame ist das primäre Datenformat, mit dem Sie arbeiten werden. So können Sie es nutzen.
Was ist Pandas?
pandas ist ein Python-Modul, das in der Datenwissenschaft und Datenanalyse beliebt ist. Es bietet eine Möglichkeit, Daten in DataFrames zu organisieren, und bietet viele Operationen, die man mit diesen Daten durchführen kann. Es wurde ursprünglich von AQR Capital Management entwickelt, aber Ende der 2000er Jahre als Open Source freigegeben.
Um pandas über PyPI zu installieren:
pip install pandas
Es ist am besten, mit pandas in einem Jupyter-Notebook oder einer anderen interaktiven Python-Sitzung zu arbeiten. IPython ist großartig für gelegentliche Datenuntersuchungen im Terminal, aber Jupyter speichert eine Aufzeichnung Ihrer Berechnungen, was hilfreich ist, wenn Sie nach Tagen oder Wochen auf einen Datensatz zurückkommen und sich nicht mehr erinnern, was Sie gemacht haben. Ich habe mein eigenes Notebook mit Codebeispielen erstellt, das Sie auf meiner GitHub-Seite einsehen können. Von dort stammen auch die Screenshots, die Sie sehen werden.
Was ist ein DataFrame?
Ein DataFrame ist die primäre Datenstruktur, mit der Sie in pandas arbeiten. Ähnlich wie bei einer Tabellenkalkulation oder einer relationalen Datenbank werden die Daten in Zeilen und Spalten organisiert. Spalten sind nach einem Kopfzeilen-Namen gruppiert. Das Konzept ähnelt den R-DataFrames, einer weiteren in der Statistik und Datenwissenschaft beliebten Programmiersprache. DataFrame-Spalten können sowohl Text- als auch numerische Daten enthalten, einschließlich Ganzzahlen und Gleitkommazahlen. Spalten können auch Zeitreihendaten enthalten.
Wie man ein DataFrame erstellt
Vorausgesetzt, Sie haben bereits pandas installiert, können Sie ein kleines DataFrame aus anderen Elementen erstellen.
Ich werde Spalten erstellen, die eine lineare Funktion darstellen, die später für die Regressionsanalyse verwendet werden könnte. Zuerst werde ich die x-Achse oder die unabhängige Variable aus einem NumPy-Array erstellen:
import numpy as np
x = np.linspace(-10,10)
Als Nächstes werde ich die y-Spalte oder abhängige Variable als eine einfache lineare Funktion erstellen:
y = 2*x + 5
Jetzt werde ich pandas importieren und das DataFrame erstellen.
import pandas as pd
Wie bei NumPy wird es das Tippen erleichtern, den Namen von pandas abzukürzen.
Die DataFrame-Methode von pandas nimmt ein Wörterbuch der Spaltennamen und der Listen der eigentlichen Daten. Ich werde ein DataFrame mit dem Namen „df“ erstellen, mit den Spalten „x“ und „y“. Die Daten werden die zuvor erstellten NumPy-Arrays sein.
df = pd.DataFrame({'x':x,'y':y})
Importieren eines DataFrames
Während es möglich ist, DataFrames von Grund auf zu erstellen, ist es üblicher, die Daten aus einer anderen Quelle zu importieren. Da der Inhalt des DataFrames tabellarisch ist, sind Tabellenkalkulationen eine beliebte Quelle. Die obersten Werte der Tabelle werden zu den Spaltennamen.
Um in einer Excel-Tabelle zu lesen, verwenden Sie die Methode read_excel:
df = pd.read_excel('/path/to/spreadsheet.xls')
Als Open-Source-Fan neige ich dazu, LibreOffice Calc gegenüber Excel zu bevorzugen, aber ich kann auch andere Dateitypen importieren. Das .csv-Format wird häufig verwendet, und ich kann meine Daten in diesem Format exportieren.
df = pd.read_csv('/path/to/data.csv')
Eine praktische Funktion ist die Möglichkeit, aus der Zwischenablage zu kopieren. Dies ist großartig für kleinere Datensätze, um zu fortgeschritteneren Berechnungen zu gelangen, als ich sie in einer Tabellenkalkulation durchführen kann:
df = pd.read_clipboard()
Untersuchung eines DataFrame
Jetzt, wo Sie ein DataFrame erstellt haben, besteht der nächste Schritt darin, die darin enthaltenen Daten zu untersuchen.
Eine Möglichkeit, dies zu tun, besteht darin, die ersten fünf Zeilen des DataFrames mit der Methode 'head' zu erhalten.
df.head()

Wenn Sie jemals den Befehl head unter Linux oder anderen Unix-ähnlichen Systemen verwendet haben, ist dies ähnlich. Wenn Sie den Befehl tail kennen, gibt es in pandas eine ähnliche Methode, die die letzten Zeilen eines DataFrames erhält.
df.tail()
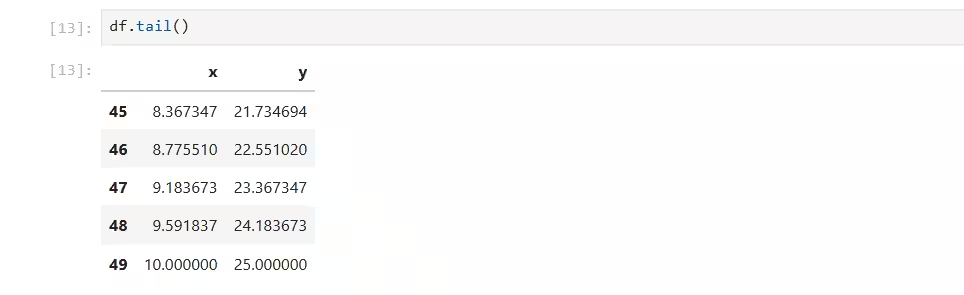
Sie können Methoden zum Array-Slicing verwenden, um eine genaue Teilmenge von Zeilen anzuzeigen. Um die Zeilen 1 bis 3 anzuzeigen:
df[1:3]

Mit dem Befehl head in Linux können Sie eine genaue Anzahl von Zeilen mit einem numerischen Argument anzeigen. Das Gleiche können Sie in pandas tun. Um die ersten 10 Zeilen zu sehen:
df.head(10)
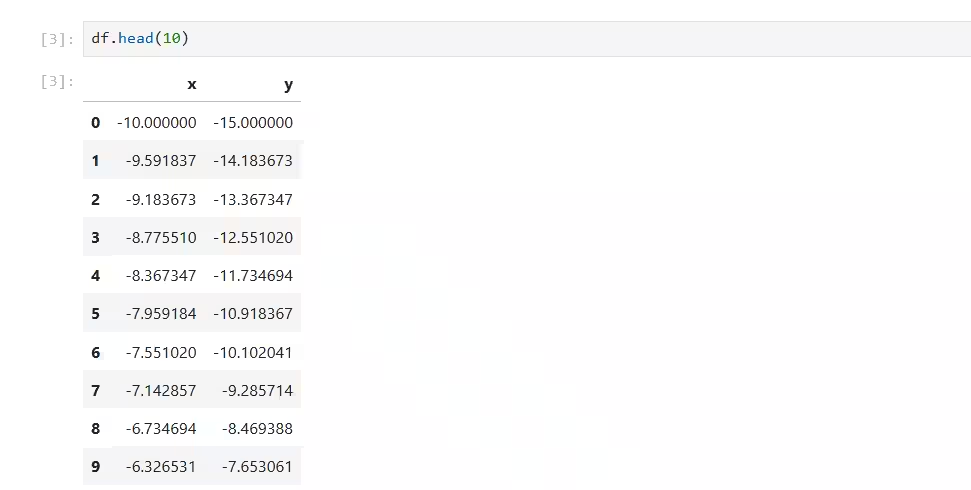
Die Tail-Methode funktioniert auf ähnliche Weise.
df.tail(10)
Interessanter ist es, bestehende Datensätze zu untersuchen. Eine beliebte Methode, dies zu demonstrieren, ist der Datensatz der Passagiere auf der Titanic. Er ist auf Kaggle verfügbar. Viele andere statistische Bibliotheken wie Seaborn und Pingouin ermöglichen es Ihnen ebenfalls, Beispieldatensätze zu laden, sodass Sie sie nicht herunterladen müssen. pandas DataFrames werden ebenfalls meist verwendet, um Daten in diese Bibliotheken einzuspeisen, zum Beispiel, um ein Diagramm zu erstellen oder eine lineare Regression zu berechnen.
Nachdem die Daten heruntergeladen wurden, müssen Sie sie importieren:
titanic = pd.read_csv('data/Titanic-Dataset.csv')
Lass uns noch einmal den Kopf ansehen
titanic.head()
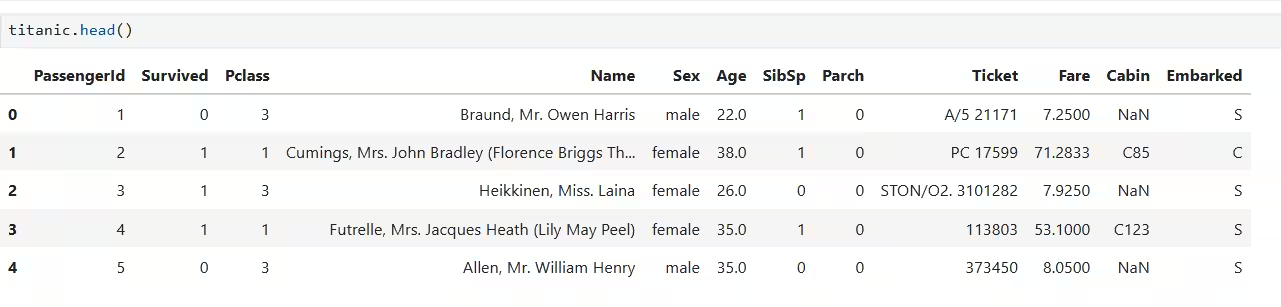
Wir können auch alle Spalten mit der Methode columns sehen
titanic.columns
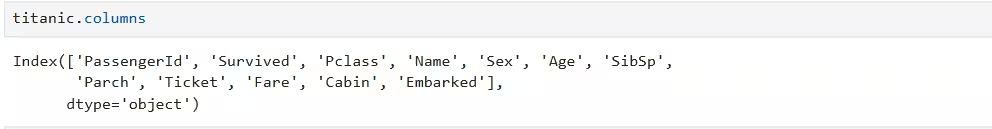
Pandas bietet viele Methoden, um Informationen über das Datenset zu erhalten. Die Methode describe liefert einige beschreibende Statistiken aller numerischen Spalten im DataFrame.
titanic.describe()
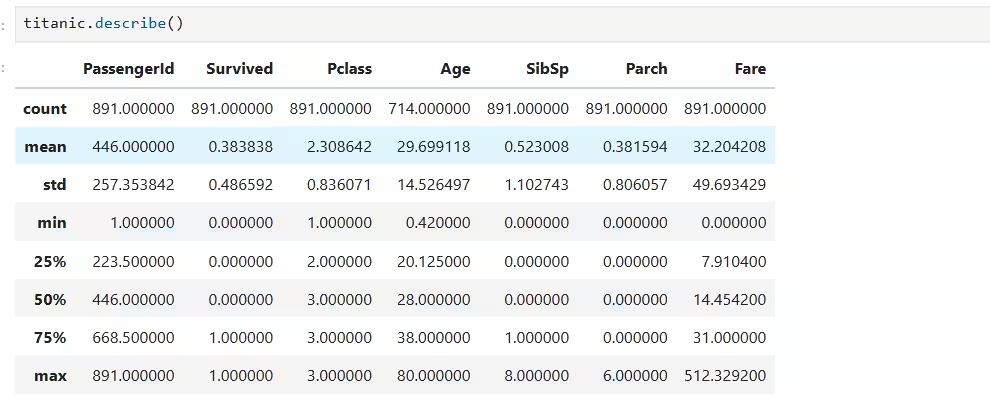
Zuerst kommt der Mittelwert, oder Durchschnitt. Als Nächstes die Standardabweichung, also wie nahe oder eng die Werte um den Mittelwert verteilt sind. Danach folgen der Minimalwert, das untere Quartil oder das 25. Perzentil, der Median oder das 50. Perzentil, das obere Quartil oder das 75. Perzentil und der Maximalwert. Diese Werte bilden die sogenannte „Fünf-Zahlen-Zusammenfassung“ des legendären Statistikers John Tukey. Mit diesen Zahlen können Sie schnell erkennen, wie Ihre Daten verteilt sind.
Um auf eine Spalte allein zuzugreifen, rufen Sie den Namen des DataFrames mit dem Namen der Spalte in eckigen Klammern ('[]') auf.
Zum Beispiel, um die Spalte mit den Namen der Passagiere anzusehen:
titanic['Name']
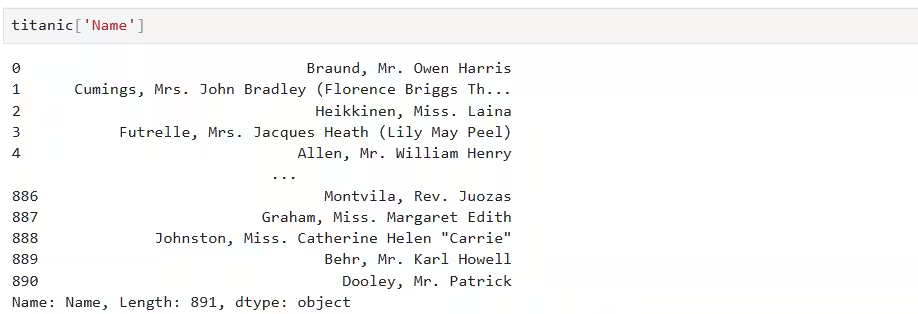
Da die Liste so lang ist, wird sie standardmäßig gekürzt. Um die vollständige Namensliste zu sehen, verwenden Sie die Methode to_string.
titanic['Name'].to_string()
Sie können die Abschneidung auch ausschalten. Um sie bei Spalten mit einer großen Anzahl von Zeilen auszuschalten:
pd.set_option('display.max_rows', None)
Sie können beim Auswählen nach Zeile auch andere Methoden verwenden. Um die beschreibenden Statistiken zu einer Spalte anzuzeigen:
titanic['Age'].describe()

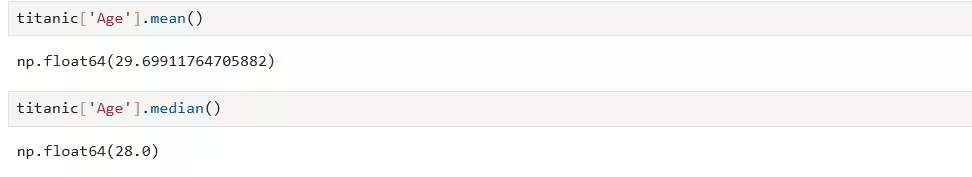
Sie können auch auf einzelne Werte zugreifen
titanic['Age'].mean()
titanic['Age'].median()
Spalten hinzufügen und löschen
Sie können nicht nur Spalten untersuchen, sondern auch neue hinzufügen. Sie können eine Spalte hinzufügen und mit Werten füllen, wie Sie es bei einem Python-Array tun würden, aber Sie können auch Daten transformieren und sie neuen Spalten hinzufügen.
Kehren wir zum ursprünglichen DataFrame zurück, den wir erstellt haben, df. Wir können Operationen auf jedem Element einer Spalte durchführen. Zum Beispiel, um die Spalte x zu quadrieren:
df['x']**2
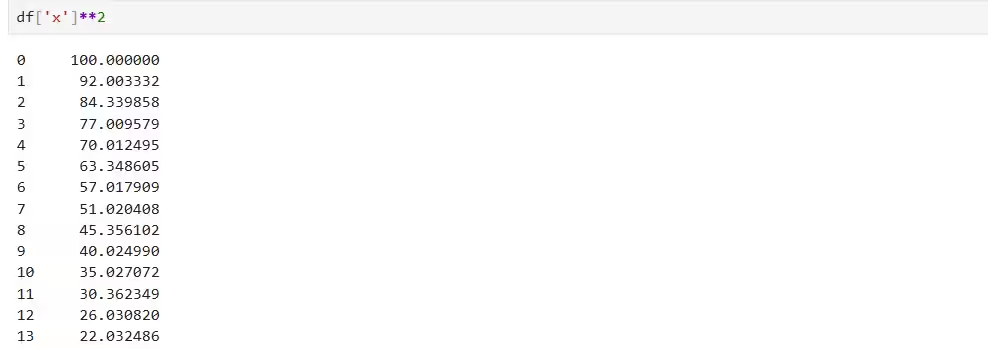
Wir können eine neue Spalte mit diesen Werten erstellen:
df['x2'] = df['x']**2
Um eine Spalte zu löschen, können Sie die Drop-Funktion verwenden.
df.drop('x2',axis=1)
Das Achsen-Argument gibt pandas an, nach Spalten statt nach Zeilen zu arbeiten.
Operationen an Spalten durchführen
Wie bereits erwähnt, können Sie Operationen an Spalten durchführen. Sie können mathematische und statistische Operationen darauf anwenden.
Wir können unsere x- und y-Spalten zusammenaddieren:
df['x'] + df['y']
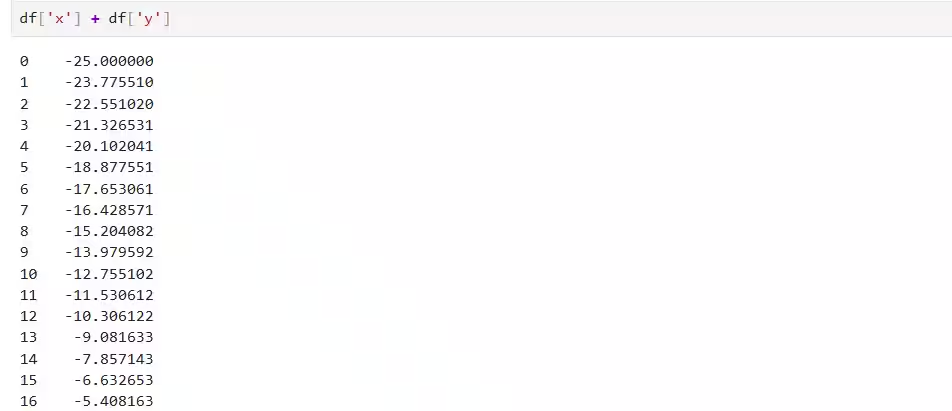
Sie können mehrere Spalten mit doppelten eckigen Klammern auswählen.
Um die Namen und das Alter der Titanic-Passagiere zu sehen:
titanic[['Name','Age']]
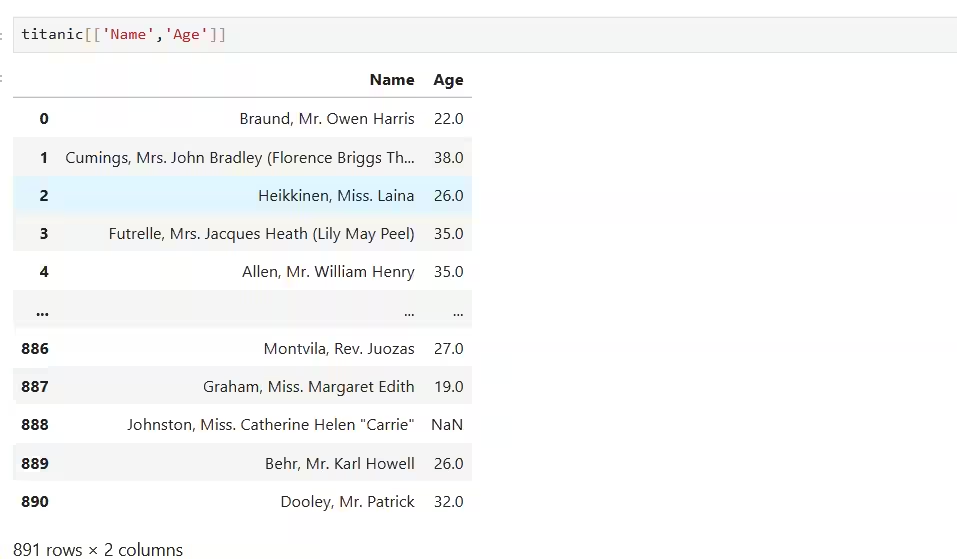
Die Spaltenelemente müssen durch ein Komma (,) getrennt sein.
Sie können auch Pandas DataFrames durchsuchen, ähnlich wie bei SQL-Abfragen. Um die Zeilen der Passagiere zu sehen, die beim Einsteigen auf das unglückliche Schiff älter als 30 Jahre waren, können Sie eine boolesche Auswahl innerhalb der Klammern verwenden:
titanic[titanic['Age'] > 30]
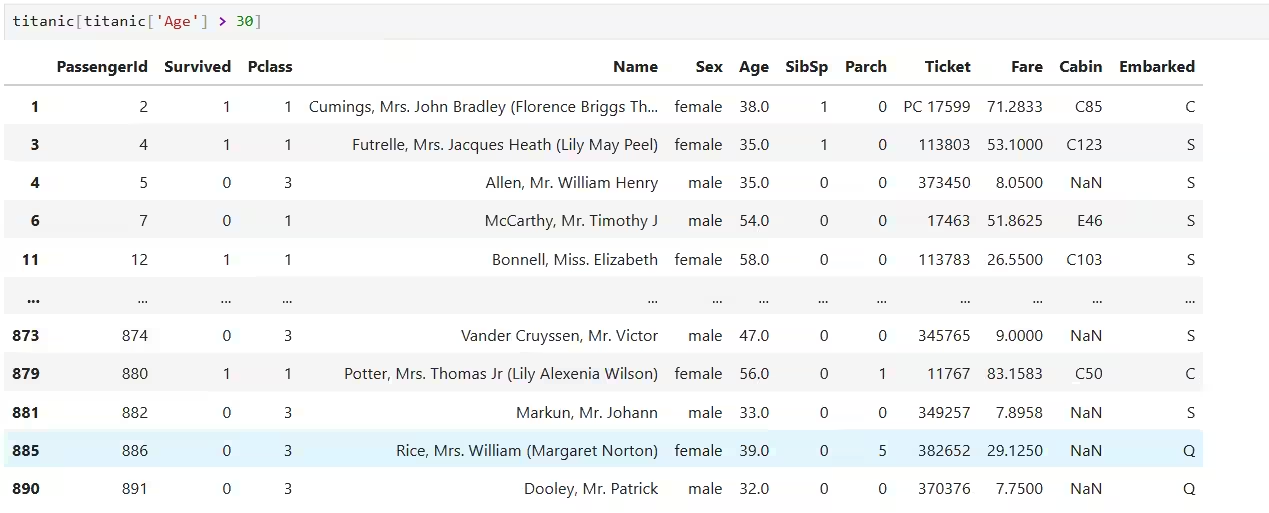
Das ist wie die SQL-Anweisung:
SELECT * FROM titanic WHERE Age > 30
Sie können die Spalte auswählen, indem Sie .loc vor den eckigen Klammern verwenden:
titanic.loc [titanic['Age'] > 30]
Lassen Sie uns ein Balkendiagramm erstellen, das zeigt, wo die Passagiere der Titanic an Bord gegangen sind. Wir können unser eigenes Teilset des DataFrames mit den drei Einschiffungspunkten erstellen: Southampton, England; Cherbourg, Frankreich; und Queenstown, Irland (heute Cobh).
embarked = titanic['Embarked'].value_counts()
Dies wird ein neues DataFrame erstellen, das die Anzahl der Personen zeigt, die an jedem Hafen eingeschifft wurden. Aber wir haben ein Problem. Die Spaltenüberschriften sind einfach Buchstaben, die für den Namen des Hafens stehen. Lassen Sie uns diese durch die vollständigen Namen der Häfen ersetzen. Die Methode rename nimmt ein Wörterbuch der alten und neuen Namen.
embarked = embarked.rename({'S':'Southhampton','C':'Cherbourg','Q':'Queenstown'})
Mit den umbenannten Spalten können wir unser Balkendiagramm erstellen. Dies ist mit pandas einfach:
embarked.plot(kind='bar')

Das sollte Ihnen helfen, mit der Erkundung von pandas-Datensätzen zu beginnen. pandas ist einer der Gründe, warum Python bei Statistikern, Datenwissenschaftlern und allen, die Daten untersuchen müssen, so beliebt geworden ist.