Verlustfunktionen in Python - Einfache Implementierung

Verlustfunktionen in Python sind ein wesentlicher Bestandteil jedes Machine-Learning-Modells. Diese Funktionen zeigen uns, wie sehr die vorhergesagte Ausgabe des Modells von der tatsächlichen Ausgabe abweicht.
Es gibt mehrere Möglichkeiten, diesen Unterschied zu berechnen. In diesem Tutorial werden wir uns einige der populäreren Verlustfunktionen ansehen.
In diesem Tutorial werden wir die folgenden vier Verlustfunktionen besprechen.
- Mittlere quadratische Abweichung
- Mittlerer quadratischer Fehler
- Mean Absolute Error
- Kreuzentropie-Verlust
Von diesen 4 Verlustfunktionen sind die ersten drei für Regressionen anwendbar, und die letzte gilt im Fall von Klassifikationsmodellen.
Implementierung von Verlustfunktionen in Python
Lass uns anschauen, wie wir diese Verlustfunktionen in Python implementieren können.
1. Mittlerer quadratischer Fehler (MSE)
Der mittlere quadratische Fehler (MSE) wird als der Durchschnitt der quadrierten Differenz zwischen Vorhersagen und tatsächlichen Beobachtungen berechnet. Mathematisch können wir ihn wie folgt darstellen:

Die Python-Implementierung für MSE ist wie folgt :
import numpy as np
def mean_squared_error(act, pred):

   diff = pred - act
   differences_squared = diff ** 2
   mean_diff = differences_squared.mean()

   return mean_diff

act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])

print(mean_squared_error(act,pred))
Ausgabe :
0.04666666666666667
Sie können auch mean_squared_error von sklearn verwenden, um MSE zu berechnen. So funktioniert die Funktion:
from sklearn.metrics import mean_squared_error
act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_squared_error(act, pred)
Ausgabe :
0.04666666666666667
2. Wurzel aus dem mittleren Quadratfehler (RMSE)
Der Wurzelmittelwertfehler (RMSE) wird als die Quadratwurzel des mittleren quadratischen Fehlers berechnet. Mathematisch können wir ihn wie folgt darstellen:

Die Python-Implementierung für RMSE ist wie folgt:
import numpy as np
def root_mean_squared_error(act, pred):

   diff = pred - act
   differences_squared = diff ** 2
   mean_diff = differences_squared.mean()
   rmse_val = np.sqrt(mean_diff)
   return rmse_val

act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])

print(root_mean_squared_error(act,pred))
Ausgabe :
0.21602468994692867
Sie können auch mean_squared_error von sklearn verwenden, um RMSE zu berechnen. Lassen Sie uns sehen, wie man das RMSE mit derselben Funktion implementiert:
from sklearn.metrics import mean_squared_error
act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_squared_error(act, pred, squared = False)
Ausgabe :
0.21602468994692867
Wenn der Parameter 'quadratisch' auf True gesetzt ist, gibt die Funktion den MSE-Wert zurück. Wenn er auf False gesetzt ist, gibt die Funktion den RMSE-Wert zurück.
3. Mittlerer absoluter Fehler (MAE)
Der mittlere absolute Fehler (MAE) wird als der Durchschnitt der absoluten Abweichungen zwischen Vorhersagen und tatsächlichen Beobachtungen berechnet. Mathematisch können wir ihn wie folgt darstellen:
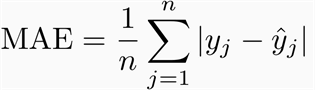
Die Python-Implementierung für MAE ist wie folgt:
import numpy as np
def mean_absolute_error(act, pred):
    diff = pred - act
    abs_diff = np.absolute(diff)
    mean_diff = abs_diff.mean()
    return mean_diff

act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_absolute_error(act,pred)
Ausgabe :
0.20000000000000004
Sie können auch mean_absolute_error von sklearn verwenden, um den MAE zu berechnen.
from sklearn.metrics import mean_absolute_error
act = np.array([1.1,2,1.7])
pred = np.array([1,1.7,1.5])
mean_absolute_error(act, pred)
Ausgabe :
0.20000000000000004
4. Kreuzentropie-Verlustfunktion in Python
Die Kreuzentropie-Verlustfunktion ist auch bekannt als die Negative Log-Likelihood. Dies wird am häufigsten für Klassifikationsprobleme verwendet. Ein Klassifikationsproblem ist eines, bei dem Sie ein Beispiel als zu einer von mehr als zwei Klassen gehörend klassifizieren.
Lass uns sehen, wie man den Fehler im Falle eines binären Klassifikationsproblems berechnet.
Betrachten wir ein Klassifikationsproblem, bei dem das Modell versucht, zwischen einem Hund und einer Katze zu unterscheiden.
Der Python-Code zur Fehlersuche ist unten angegeben.
from sklearn.metrics import log_loss
log_loss(["Dog", "Cat", "Cat", "Dog"],[[.1, .9], [.9, .1], [.8, .2], [.35, .65]])
Ausgabe :
0.21616187468057912
Wir verwenden die log_loss-Methode von sklearn.
Das erste Argument im Funktionsaufruf ist die Liste der korrekten Klassennamen für jede Eingabe. Das zweite Argument ist eine Liste der Wahrscheinlichkeiten, wie sie vom Modell vorhergesagt werden.
Die Wahrscheinlichkeiten sind im folgenden Format:
[P(dog), P(cat)]
Schlussfolgerung
Dieses Tutorial handelte von Verlustfunktionen in Python. Wir haben verschiedene Verlustfunktionen für sowohl Regressions- als auch Klassifikationsprobleme behandelt. Ich hoffe, es hat Ihnen Spaß gemacht, mit uns zu lernen!