EDA - Explorative Datenanalyse: Verwendung von Python-Funktionen

In den vorherigen Artikeln haben wir gesehen, wie man EDA mithilfe grafischer Methoden durchführt. In diesem Artikel werden wir uns auf Python-Funktionen konzentrieren, die für die explorative Datenanalyse in Python verwendet werden. Wie wir alle wissen, ist EDA sehr wichtig, da es ein kurzes Verständnis der Daten vermittelt. Also, ohne viel Zeit zu verschwenden, lass uns anfangen!
Explorative Datenanalyse - EDA
- EDA wird angewendet, um die Daten zu untersuchen und die wichtigsten Erkenntnisse zusammenzufassen.
- Es wird Ihnen ein grundlegendes Verständnis Ihrer Daten vermitteln, ihre Verteilung, Nullwerte und vieles mehr.
- Sie können entweder Daten mithilfe von Grafiken oder durch einige Python Funktionen erkunden.
- Es wird zwei Arten von Analysen geben. Univariate und Bivariate. In der univariaten Analyse werden Sie ein einzelnes Attribut analysieren. In der bivariaten Analyse hingegen werden Sie ein Attribut zusammen mit dem Zielattribut analysieren.
- Im nicht-grafischen Ansatz verwenden Sie Funktionen wie shape, summary, describe, isnull, info, datatypes und mehr.
- Im grafischen Ansatz verwenden Sie Diagramme wie Streudiagramme, Boxplots, Balkendiagramme, Dichte- und Korrelationsdiagramme.
Lade die Daten
Nun, zuerst die wichtigsten Dinge. Wir werden den Titanic-Datensatz in Python laden, um eine explorative Datenanalyse durchzuführen.
#Load the required libraries
import pandas as pd
import numpy as np
import seaborn as sns

#Load the data
df = pd.read_csv('titanic.csv')


#View the data
df.head()

Unsere Daten sind bereit, erkundet zu werden!
1. Grundlegende Informationen über Daten - EDA
Die df.info() Funktion gibt uns grundlegende Informationen über den Datensatz. Für jede Datenmenge ist es gut, mit dem Wissen um ihre Informationen zu beginnen. Lassen Sie uns sehen, wie es mit unseren Daten funktioniert.
#Basic information

df.info()

#Describe the data

df.describe()

- Beschreiben Sie die Daten - Deskriptive Statistiken.

Mit dieser Funktion können Sie die Anzahl der Nullwerte, Datentypen und den Speicherverbrauch sehen, wie in den obigen Ausgaben gezeigt, zusammen mit beschreibenden Statistiken.
2. Duplikate Werte
Sie können die Funktion df.duplicate.sum() verwenden, um die Summe der vorhandenen doppelten Werte zu berechnen, falls vorhanden. Sie zeigt die Anzahl der doppelten Werte an, wenn sie in den Daten vorhanden sind.
#Find the duplicates

df.duplicated().sum()
0
Nun, die Funktion hat '0' zurückgegeben. Das bedeutet, dass kein einziges Duplikat in unserem Datensatz vorhanden ist und es eine sehr gute Sache ist, das zu wissen.
3. Einzigartige Werte in den Daten
Sie können die Anzahl der einzigartigen Werte in der bestimmten Spalte mit der unique() Funktion in Python finden.
#unique values

df['Pclass'].unique()

df['Survived'].unique()

df['Sex'].unique()
array([3, 1, 2], dtype=int64)


array([0, 1], dtype=int64)


array(['male', 'female'], dtype=object)
Die unique() Funktion hat die einzigartigen Werte zurückgegeben, die in den Daten vorhanden sind, und das ist ziemlich cool!
4. Visualisieren Sie die einzigartigen Zählungen
Ja, Sie können die einzigartigen Werte in den Daten visualisieren. Dafür werden wir die Seaborn-Bibliothek verwenden. Sie müssen die Funktion sns.countplot() aufrufen und die Variable angeben, um das Zähl-Diagramm zu erstellen.
#Plot the unique values

sns.countplot(df['Pclass']).unique()

Das ist großartig! Du machst das gut. Es ist so einfach. Obwohl die explorative Datenanalyse zwei Ansätze hat, wird eine Kombination aus grafischen und nicht-grafischen Methoden dir das Gesamtbild vermitteln.
5. Finden Sie die Nullwerte
Das Finden der Nullwerte ist der wichtigste Schritt in der EDA. Wie ich oft gesagt habe, ist die Gewährleistung der Datenqualität von größter Bedeutung. Lassen Sie uns also sehen, wie wir die Nullwerte finden können.
#Find null values

df.isnull().sum()
PassengerId      0
Survived         0
Pclass           0
Name             0
Sex              0
Age            177
SibSp            0
Parch            0
Ticket           0
Fare             0
Cabin          687
Embarked         2

dtype: int64
Oh nein, wir haben einige Nullwerte in den ‘Alter’ und ‘Kabine’ Variablen. Aber keine Sorge, wir werden bald einen Weg finden, um damit umzugehen.
6. Ersetzen Sie die Nullwerte
Hey, wir haben eine replace()-Funktion, um alle Nullwerte durch spezifische Daten zu ersetzen. Es ist zu gut!
#Replace null values

df.replace(np.nan,'0',inplace = True)

#Check the changes now
df.isnull().sum()
PassengerId    0
Survived       0
Pclass         0
Name           0
Sex            0
Age            0
SibSp          0
Parch          0
Ticket         0
Fare           0
Cabin          0
Embarked       0

dtype: int64
Wow! Das ist großartig. Es ist sehr einfach, die Nullwerte in den Daten zu finden und zu ersetzen, wie gezeigt. Ich habe 0 verwendet, um Nullwerte zu ersetzen. Sie können sogar sinnvollere Methoden wählen, wie den Mittelwert oder den Median.
7. Kenne die Datentypen
Es ist sehr wichtig, die Datentypen zu kennen, die Sie erkunden, und es ist ein einfacher Prozess. Lassen Sie uns sehen, wie es funktioniert.
#Datatypes

df.dtypes
PassengerId      int64
Survived         int64
Pclass           int64
Name            object
Sex             object
Age             object
SibSp            int64
Parch            int64
Ticket          object
Fare           float64
Cabin           object
Embarked        object

dtype: object
Das ist es. Du musst die dtypes-Funktion dafür verwenden, wie gezeigt, und du wirst die Datentypen jedes Attributs erhalten.
8. Die Daten filtern
Ja, Sie können die Daten basierend auf einer bestimmten Logik filtern.
#Filter data

df[df['Pclass']==1].head()

Sie können sehen, dass der obige Code nur Datenwerte zurückgegeben hat, die zur Klasse 1 gehören.
9. Ein schneller Boxplot
Sie können mit einer einzigen Codezeile ein Box-Plot für jede numerische Spalte erstellen.
#Boxplot

df[['Fare']].boxplot()

10. Korrelationsdiagramm - EDA
Um schließlich die Korrelation zwischen den Variablen zu finden, können wir die Korrelationsfunktion verwenden. Dies gibt Ihnen eine gute Vorstellung von der Stärke der Korrelation zwischen verschiedenen Variablen.
#Correlation

df.corr()

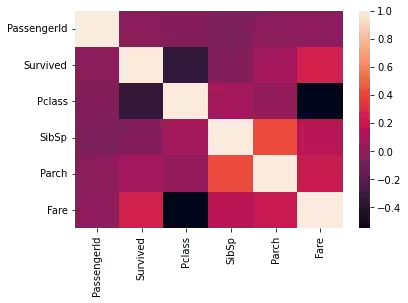
Dies ist die Korrelationsmatrix mit einem Bereich von +1 bis -1, wobei +1 stark und positiv korreliert ist und -1 stark negativ korreliert.
Sie können sogar die Korrelationsmatrix mit der Seaborn-Bibliothek visualisieren, wie unten gezeigt.
#Correlation plot

sns.heatmap(df.corr())
Abschlussbemerkung - EDA
EDA ist der wichtigste Teil jeder Analyse. Sie werden viele Dinge über Ihre Daten erfahren. Sie werden mit EDA Antworten auf die meisten Ihrer Fragen finden. Ich habe versucht, die meisten Python-Funktionen zu zeigen, die für die Exploration der Daten mit Visualisierungen verwendet werden. Ich hoffe, Sie haben etwas aus diesem Artikel mitgenommen.
Das ist alles für jetzt! Viel Spaß mit Python :)
Mehr lesen: Explorative Datenanalyse